代理返回 502、503、504 怎么排查:网关、上游节点、目标站和重试边界
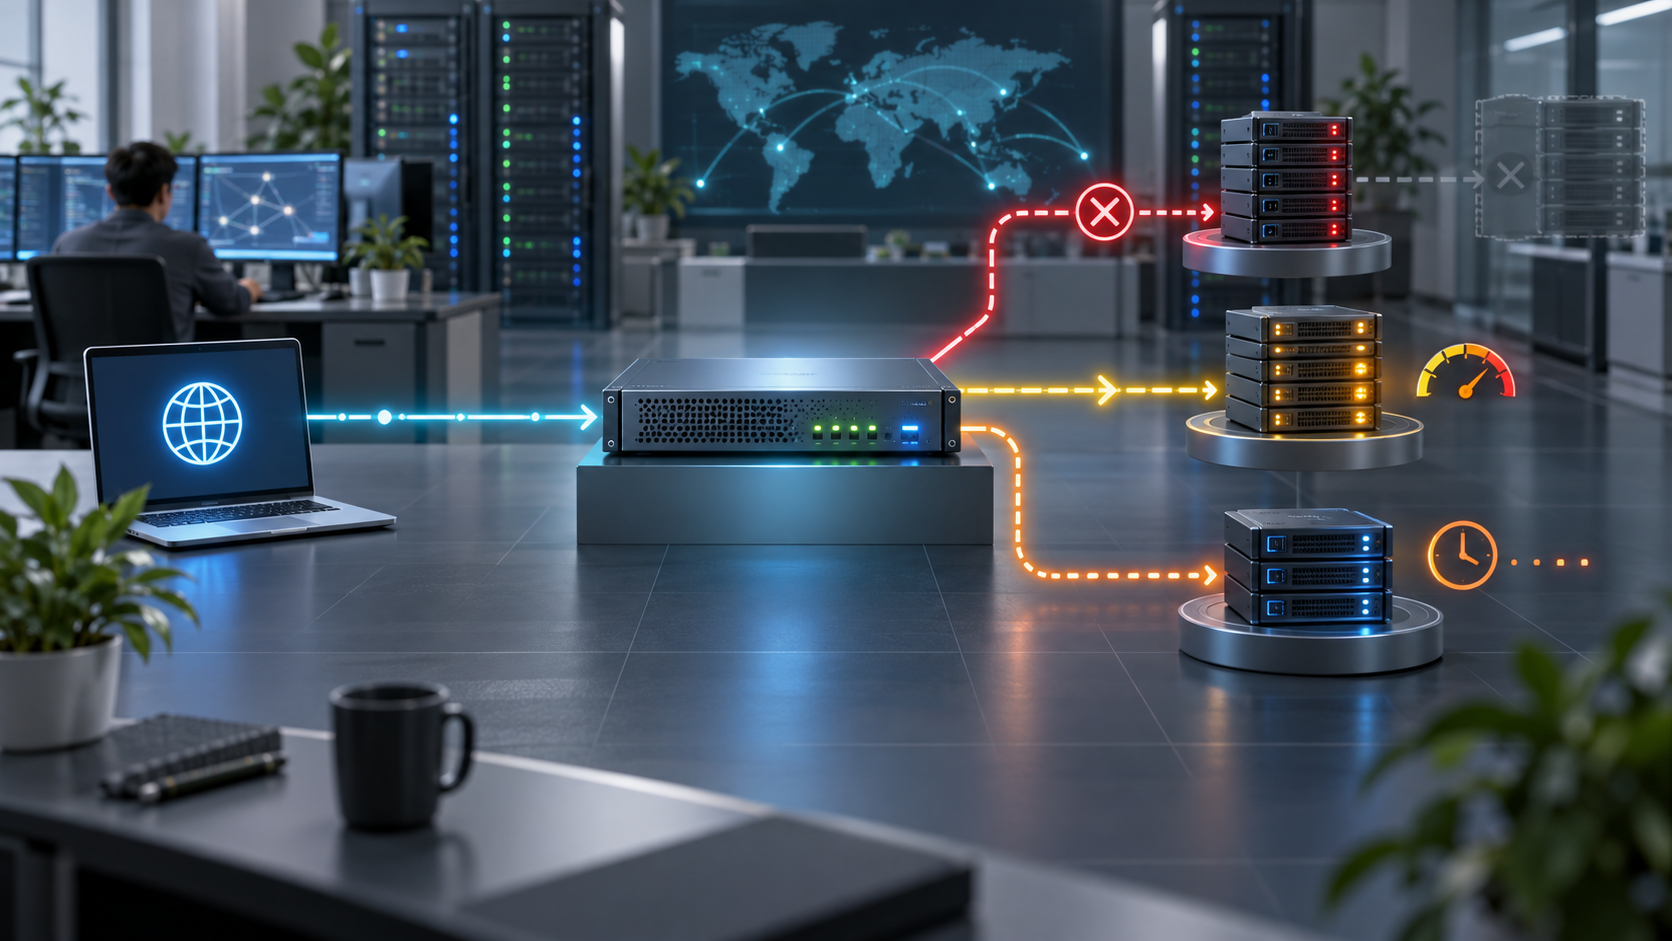
代理请求返回 502、503 或 504 时,问题已经不只是“能不能连上代理”。这三个状态通常表示某个网关或中间服务在转发请求时,没有从上游得到可用结果。排查的第一件事,是确认状态码由代理入口、上游节点、反向代理还是目标站发出;如果连错误来源都没有确定,直接更换线路或连续重试只会增加变量。
本次排查应固定客户端、代理协议、目标地址、请求方法和测试时间窗口。先保存完整状态码、响应头、响应体摘要、连接耗时、首包时间、出口 IP 和请求标识,再做最小复测。任何一步仍无法解释错误来源时,都应暂停批量任务。
先分清 502、503 和 504 分别在说什么
502 通常表示网关从上游收到无效响应;503 表示服务暂时不可用,常见于维护、过载或资源耗尽;504 表示网关等待上游响应超时。它们描述的是网关看到的结果,不一定能直接证明哪台服务器发生故障。
同一个状态码也可能由不同网络跳点生成。先查看响应头、错误页样式、服务器标识、请求追踪字段和时间特征,判断它来自本地代理入口、服务商网关、上游出口还是目标站。若请求在建立连接前就被拒绝,应转入主机、端口与防火墙检查顺序,不要继续按网关错误处理。
第一步:保存一份可复现的最小请求
选一个不会改变账号或业务状态的轻量请求,固定目标域名、路径、方法、请求头、代理协议和认证方式,连续测试少量次数。每次记录开始时间、DNS 结果、连接耗时、TLS 耗时、首包时间、总耗时、状态码、响应头和请求标识。
- 通过条件:错误可以在相同条件下稳定复现,且能够确定生成状态码的网络跳点。
- 失败条件:同一条件在 502、503、504、超时和成功之间无规律变化。
- 停止条件:最小请求会触发写入、登录、支付或其他不可逆业务动作。
重试次数和间隔应提前写明。可以沿用超时、错误码与重试顺序中的记录方式,避免测试脚本在故障期间形成无上限循环。
第二步:判断故障范围是单目标、单线路还是全入口
用同一代理线路访问两个经过批准的低风险目标,再用另一条已知正常线路访问原目标。一次只改变一个变量,以区分目标站故障、单个上游节点故障和整个代理入口故障。
| 复测结果 | 更可能的位置 | 下一步 |
|---|---|---|
| 同一线路仅一个目标报错 | 目标站或该目标的上游路径 | 比较目标站状态、DNS、TLS 和响应时间 |
| 同一线路多个目标报错 | 代理入口、上游节点或共享网关 | 检查节点状态与服务范围 |
| 换线路后原目标恢复 | 原线路或原节点路径 | 隔离原线路并做冷却复测 |
| 所有线路访问原目标都报错 | 目标站、公共上游或本地请求条件 | 停止扩量并保留请求证据 |
| 结果持续来回变化 | 容量、负载均衡或间歇性上游故障 | 降低频率并扩大观察窗口 |
第三步:检查网关到上游节点的连接条件
确认上游主机、端口、协议入口和认证范围仍然有效。502 可能来自错误协议或上游返回内容无法解析,504 可能来自上游连接或响应阶段超时,503 则可能表示节点暂时不接收新请求。检查时要区分连接超时、TLS 握手、首包等待和响应传输。
如果错误集中在 TLS 阶段,使用SNI、证书和协议链路检查表逐项核对;如果网关已经收到响应但页面仍很慢,则对照延迟、首包和并发检查方法拆开测量,不要只看总耗时。
第四步:核对容量、并发和维护窗口
503 常见于服务维护、连接池耗尽、节点过载或容量保护,但不能只凭状态码断定原因。把并发降到一个请求,关闭自动重试,再比较低并发和原并发下的成功率、首包时间与错误分布。如果低并发稳定而并发提高后 503 增多,应先保留容量证据,不要立即恢复原负载。
同时确认是否存在已公告的维护窗口、节点下线、线路迁移或配额限制。没有维护信息时,记录异常开始时间、受影响节点、请求量和恢复时间,由维护方确认服务状态。
第五步:为重试和故障切换设置边界
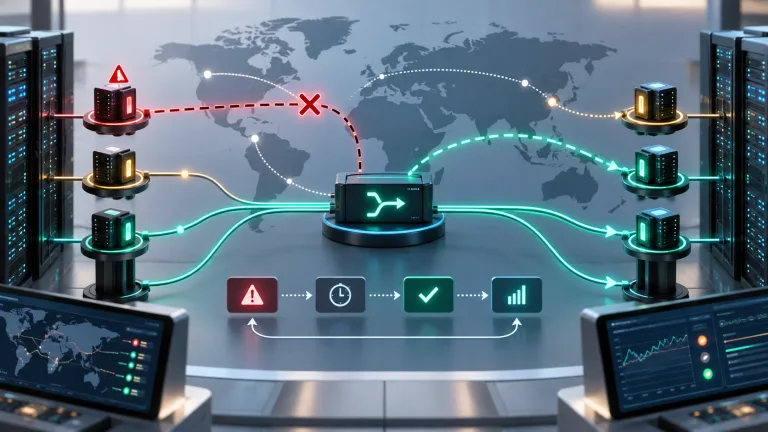
502、503、504 都可能是暂时错误,但不代表所有请求都适合自动重试。只读且可重复的请求可以在有限次数内采用递增等待;会改变业务状态的请求,必须先确认上一次是否已经被上游执行,避免重复提交。
- 限定最大尝试次数和总等待时间。
- 503 带有明确等待提示时,按提示安排下一次测试。
- 504 后先确认上游是否已接收或执行请求。
- 连续失败达到阈值后进入冷却,不再立即切换。
- 故障切换后使用少量无状态请求验证,再恢复业务。
需要跨线路恢复时,使用连续失败、冷却时间与恢复条件作为切换门槛,避免单次网关波动触发整批任务迁移。
502、503、504 排查决策表
| 检查层 | 要记录的证据 | 通过条件 | 失败后动作 |
|---|---|---|---|
| 错误来源 | 响应头、错误页、请求标识、生成时间 | 能确定状态码由哪一跳产生 | 停止改配置,先补齐来源证据 |
| 故障范围 | 目标、线路、节点和时间窗口 | 能区分单目标、单线路或全入口 | 隔离变量后重新做最小复测 |
| 上游连接 | DNS、端口、TLS、连接和首包耗时 | 上游入口有效且响应阶段明确 | 转入协议、证书或节点维护检查 |
| 容量状态 | 并发、成功率、503 分布、维护信息 | 低并发稳定且容量边界可解释 | 降并发、冷却并联系维护方 |
| 重试安全 | 请求是否可重复、上次执行结果 | 重试不会造成重复业务动作 | 停止自动重试并人工确认状态 |
| 恢复验证 | 连续成功次数、出口、延迟和错误码 | 小流量窗口内结果持续稳定 | 移出可用池并保留故障记录 |
修复后按小流量顺序恢复
状态码消失后,先验证代理出口、目标站响应、DNS、TLS、首包时间和会话要求,再运行少量无状态请求。只有连续结果稳定、错误来源已经解释、旧请求执行状态已经确认,才恢复需要保持会话或会改变业务状态的任务。
不要把一次 200 响应当作完全恢复。记录连续成功次数、观察窗口、节点、出口 IP、并发、平均首包时间和最后一次网关错误。若 502、503、504 在短时间内再次出现,应把线路移出可用池,而不是提高重试次数。
把网关错误写进日常记录
团队记录至少应包含请求时间、目标域名、代理入口、出口 IP、节点、状态码、响应头摘要、DNS 结果、连接耗时、TLS 耗时、首包时间、并发、重试次数、请求标识、恢复动作和负责人。可以直接扩展出口 IP、状态码与会话日志模板,让每次网关错误都能按相同字段复盘。
最终判断不是“这个状态码要不要换代理”,而是错误由哪一跳产生、影响范围有多大、请求是否可以安全重试,以及何时达到暂停或恢复条件。只有这些问题有记录,502、503、504 才能从模糊故障变成可验证的网络事件。